Normalisering av datastruktur
När vi informationsmodellerar behöver vi förstå vad en normaliserad datastruktur innebär. Begreppet har sitt ursprung i en metod för databasdesign som utvecklades vid IBM i början av 1970-talet, men principerna är lika viktiga idag.
Vad man vill uppnå: Normaliserad datastruktur
Relationsdatabaser är tänkta för en datastruktur som följer de regler som ges av det som kallas relationsmodellen, en modell som bygger på mängdlära och predikatlogik. Modellen introducerades av IBM-forskaren Edgar F. Codd år 1970. Relationsdatabaser saknar, till skillnad från andra typer av databastyper, en särskild inbyggd konstruktion för att definiera länkar mellan databas-objekt. Länkarna blir i stället logiska och baseras på hur tabellkolumner definieras. Man definierar så kallade främmande nycklar, det vill säga kolumner med värden som mappar mot primärnycklar i en annan tabell.
Att designa en databas för en viss datamängd innebär att man tar fram ett databasschema, det vill säga bestämmer vilka tabeller och kolumner man ska ha och vilka regler och samband som ska gälla för dessa. Målet är inte bara att lagra rätt data utan också att få en så kallad normaliserad datastruktur, där data är uppdelade på tabeller enligt bestämda regler. Det man vill undvika är onödig redundans, det vill säga att samma uppgift lagras på flera ställen. Det främsta skälet är att det då är lättare att undvika inkonsistens, det vill säga motsägelsefulla data, som kan uppstå då man behöver uppdatera samma uppgift på flera ställen.
| Se upp med att termerna normalisering och normaliserade data har en annan mening för dataanalytiker. Då handlar det om att man ensar olika datamängder efter samma måttstock. Detta går tillbaka på den bredare betydelsen av termen ”normalisering”: att man formar data efter vissa gemensamma normer. |
Hur man går till väga: Normalisering eller ER-modellering
Den arbetsprocess Codd förespråkade för att uppnå en normaliserad datastruktur kallades normalisering och innebar att man steg för steg fördelade en tänkt datamängd (ett antal kolumner eller fält) på flera tabeller. Processen tar datastrukturen genom ett antal så kallade normalformer till en allt högre grad av normalisering. De vanligaste stegen är första normalformen (1NF), andra normalformen (2NF) och tredje normalformen (3NF). Det finns också högre normalformer, men de är sällan aktuella i vanlig databasdesign. Det vanliga är att nöja sig med tredje normalformen, vilket i allmänhet likställs med en normaliserad datastruktur.
Några år senare, 1976, introducerade den amerikansk-taiwanesiske dataforskaren Peter Chen en grafisk och mera direkt metod att uppnå samma resultat, det vill säga en normaliserad datastruktur, utan att gå igenom Codds stegvisa förfarande. Den metoden kallas Entity-Relationship modeling (ER-modeling).
ER-modellering blev snabbt den förhärskande metoden för att designa en normaliserad datastruktur, inte bara när det gäller databasdesign. I snarlika varianter är den fortfarande grundmetoden för hur vi som informationsmodellerare vanligen modellerar alla slags informationsmängder och begrepp.
Dock är det bra för oss att känna till Codds ursprungliga tankar för att förstå vad normalisering och normalformerna innebär. Ty normaliserade data- och informationsstrukturer är fortfarande viktiga i de flesta sammanhang, även om vi inte går till väga på samma mekaniska sätt som Codd tänkte sig.
Jag vill därför i denna artikel beskriva normaliseringsmetoden. Enklast görs det med ett tänkt exempel.
Exempel på normalisering: Utgångsläget
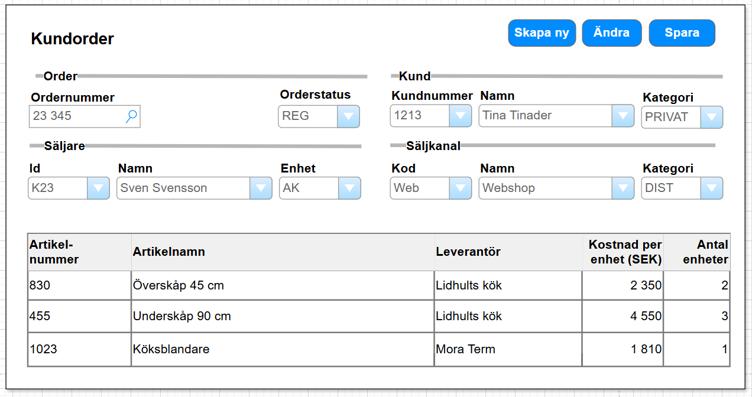
Vi tänker oss att vi ska designa en databas till en applikation för att hantera kundordrar. För att fånga behoven har vi en skiss för användargränssnittet att utgå från, som illustrationen visar.
När en ny order kommer in registrerar säljaren vilken kund, säljare och säljkanal som ordern avser samt artiklar och antal. Vid registrering får ordern automatiskt ett nytt ordernummer och orderstatus REG, som står för Registrerad. Senare, när ordern hanteras, ändrar man orderstatus till AKT (Aktiv) och STÄ (Stängd) när den är levererad eller på annat sätt avslutad. Kunden anges med kundnummer; namn och kundkategori hämtas automatiskt från kundregistret. Kundkategori kan vara PRIVAT (Privatperson) eller ORG (Organisation). Säljare anges med säljar-id, varvid namn och kod för säljenhet hämtas automatiskt. Säljaren anges med säljar-id, varvid namn och överordnad kategori för säljkanalen hämtas, i detta fall DIST (Distanshandel).
Säg att vi nu vill registrera ordrar i en databas.
För exemplets skull måste vi glömma allt vi redan vet om ER-modellering och i stället tänka rent mekaniskt på det sätt som Codd tänkte sig.
Om vi sålunda föreställer oss att vi skulle spara all information bara rakt av i en databastabell, skulle den kunna se ut så här.
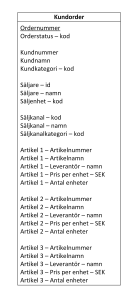
Varje attribut motsvarar en kolumn i tabellen. Det är en helt onormaliserad struktur. Denna lösning fungerar inte så bra då det gäller operativa system där man behöver uppdatera saker. Många uppgifter dubbellagras, vilket ställer till det när vi vill ändra något. Om vi till exempel upptäcker att vi stavat fel på ett artikelnamn så måste vi gå in på varje enskild order med denna artikel för att korrigera artikelnamnet.
Det vi eftersträvar då det gäller operativa system, det vill säga system där vi hanterar verksamhetens händelser, är att undvika onödig redundans: att samma uppgift inte ska behöva lagras på flera ställen.
Ett annat problem med denna naiva struktur är att vi i förväg behöver bestämma och lämna utrymme för hur många orderrader (artiklar) vi kan registrera, samtidigt som ordrar med färre orderrader resulterar i många tomma kolumner.
Vi ska nu steg för steg omforma denna struktur för att minska dubbellagringen och slippa begränsa antalet orderrader. Vi gör det genom att tillämpa så kallade normaliseringsregler. Efter varje steg uppnår vi en högre normalform.
En första check
Men innan vi sätter igång med själva normaliseringen behöver vi checka av och eventuellt korrigera några saker som normaliseringsmetodiken förutsätter.
1. Endast en uppgift per kolumn
Vi behöver se till att varje kolumn inte innehåller fler än en uppgift. I detta fall är det kanske osäkert om säljarnas id egentligen är en kombination av två uppgifter. ”K” kanske står för någon speciell kategori av säljare. I så fall behöver vi bryta isär detta till två olika termer och motsvarande kolumner. Men vi antar att det inte är så i detta fall.
2. Hitta gömda data
Det är förmodligen så att man vill kunna hålla reda på det datum då ordern skapas. Det kanske kan registreras automatiskt vid registreringen. Alltså behöver vi lägga till en kolumn för det.
3. Ta bort härledda data
Om vi hade haft med pris per orderrad så kunde det härledas som produkten av pris per enhet och antal enheter. Det skulle då vara redundant att lagra uppgift som en egen kolumn. Och vidare, om totalpriset för ordern varit med så hade det kunnat härledas som summan av pris per orderrad och likaledes också vara redundant att lagra som en egen kolumn.
4. Bestäm primärnyckel
Primärnyckel för en tabell är en eller flera kolumner vars innehåll tillsammans unikt identifierar varje rad i tabellen. Det kan finnas fler sådana möjliga sådana möjliga nycklar, så kallade kandidatnycklar. En av dessa väljs som primärnyckel.
I detta fall kan vi använda ordernummer. Men om olika säljenheter använde sina egna serier av ordernummer skulle vi behöva en kombination av två kolumner: säljenhetens id och ordernumret, för att identifiera en order entydigt.
Nu är vi klara att sätta igång med själva normaliseringsförfarandet.
Första normalformen: Bryt ut repeterade grupper
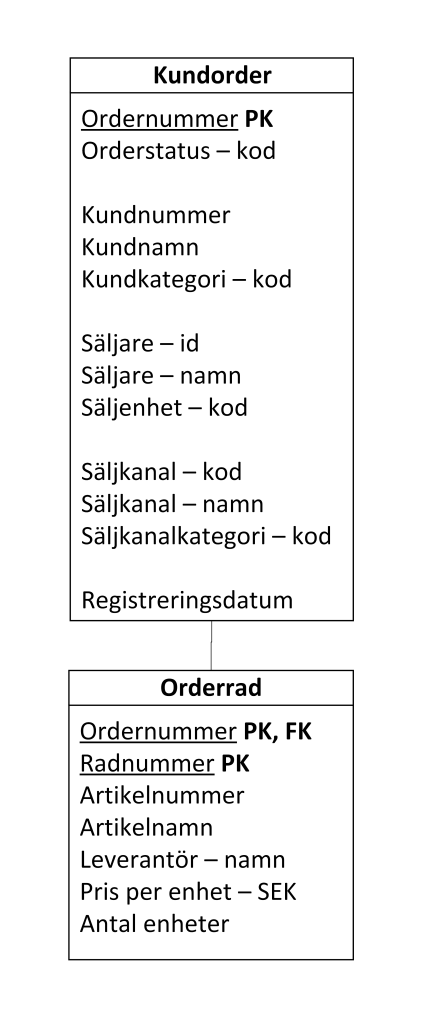 Vi vill inte i förväg behöva bestämma hur många orderrader vi behöver utan vill kunna hantera allt från en till hur många som helst. Vi gör det genom att bryta ut orderrader till en egen tabell, enligt följande:
- Varje orderrad blir en egen tabellrad.
- Inkludera primärnyckeln från den ursprungliga tabellen i tabellen för orderrader, så att den fungerar som en korsreferens och pekar ut vilket ordernummer orderraden tillhör.
- I det fall ordningen på orderrader har betydelse, inkludera ett sekvensnummer.
- Ge den nya tabellen ett namn
- Identifiera primärnyckel för den nya tabellen
Vi har nu nått det som kallas första normalformen (1NF). Kriteriet för detta är att alla data av samma sort ska finnas på samma ställe. I detta fall är alla artikelnummer i en och samma kolumn. Vi kan då till exempel sortera alla orderrader för alla kundordrar i hela databasen efter artikelnummer.
Andra (2NF) och tredje (3NF) normalformen
Nu återstår att undersöka vilka uppgifter som egentligen hör samman. Andra normalformen handlar om att uppgifter som inte ingår i en nyckel ska vara beroende av hela nyckeln, inte bara en del av den. Det är särskilt relevant när en tabell har en sammansatt nyckel. Tredje normalformen går ett steg längre: uppgifter ska inte vara beroende av andra uppgifter som i sin tur bestäms av nyckeln. I praktiskt modelleringsarbete kan vi ofta hantera båda stegen tillsammans.
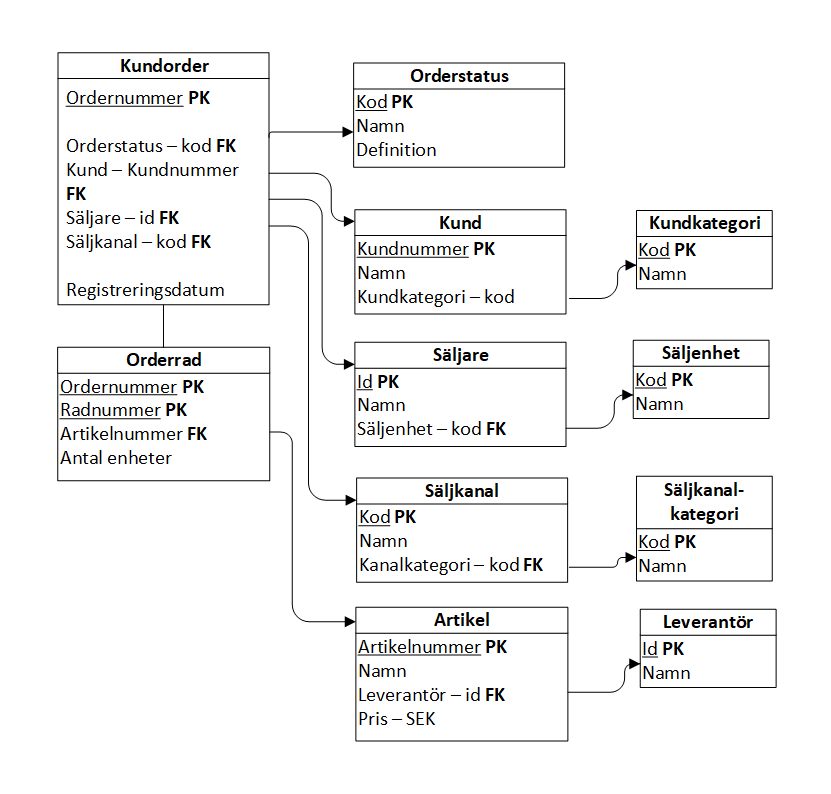
För att nå tredje normalformen behöver vi bryta ut uppgifter för att undvika redundans. Vi undersöker vad som bestämmer vad och bryter ut uppgifter som annars skulle upprepas på flera ställen.
I vårt exempel gäller det till exempel orderstatuskoder, kunder, säljare, säljenheter, säljkanaler, säljkanalkategorier, artiklar och leverantörer.
Rent formellt gör vi på följande sätt: Vi identifierar vilka kolumner som bestämmer andra kolumner. Till exempel bestäms Kundnamn och Kundkategori av Kundnummer. Det betyder att dessa kunduppgifter hör hemma tillsammans och behöver inte upprepas för varje order. Vi bryter ut alla sådana sammanhörande kolumner till egna tabeller med egna namn och primärnycklar. På motsvarande sätt kan vi analysera artikeluppgifter och andra uppgifter som förekommer på många orderrader.
Mer praktiskt uttryckt skapar vi egna tabeller för återkommande företeelser som kunder, säljare och artiklar och även referenstabeller eller ”look-up tables” för olika kodvärden som status, kategorier med mera. Vi kan också behöva lägga till beskrivande uppgifter i dessa tabeller, till exempel namn och definitioner för för orderstatus.
Högre normalformer
Man har beskrivit högre normalformer än 3NF, men i praktiken behöver man inte särskilt ofta bry sig om dessa. 3NF betecknas, som tidigare sagts, som en normaliserad struktur. Men vi kan ändå nämna de högre normalformerna Boyce-Codd Normal Form (BCNF), fjärde och femte normalformen (4NF, 5NF). Det har även föreslagits en sjätte normalform (6NF) för att hantera tidsberoende data.
Definitionen av tredje normalformen
Rent tekniskt definierar man tredje normalformen som att innehållet i en tabells alla kolumner som inte är en del av primärnyckeln, ska bero av hela primärnyckeln och inte av något annat.
För att komma ihåg vad tredje normalformen innebär har man hittat på den fyndiga formuleringen:
Each nonkey column must be determined by the key, the whole key, and nothing but the key – So help me Codd
Vilket är en parafras på hur man i amerikanska domstolar svär ”I swear to tell the truth, the whole truth, and nothing but the truth – So help me God”
Denormalisering
I vissa fall kan man medvetet välja att avvika från en normaliserad struktur, till exempel genom att lagra samma uppgift på flera ställen för att förenkla åtkomst eller förbättra prestanda. Det kallas att denormalisera datastrukturen. Det kan vara ett rimligt designval, men då bör man också förstå vilka beroenden och risker för inkonsistens man inför.
ER-modellering i stället för en särskild procedur för att normalisera
Normaliserade datastrukturer är viktiga, särskilt för operativa system. Men jag undrar hur många som i praktiken går igenom de successiva normalformerna på det mekaniska sätt som beskrivits här. Med ER-modellering kan man få samma resultat på ett smidigare och mer åskådligt sätt. Det förutsätter förstås att vi förstår vilka företeelser och uppgifter som hör samman och vilka beroenden som gäller. Normaliseringsprinciperna är fortfarande viktiga, även om vi tar en annan väg till resultatet. Därför denna artikel.
Normaliserade data- och informationsstrukturer har alltså inte bara betydelse för databasdesign. Principerna är också viktiga för våra informationsmodeller som bygger på ER-modellering. Då handlar det oftast inte om att skapa en databas utan om att skapa en gemensam förståelse för verksamhetens företeelser med gemensamma begrepp och ett gemensamt språk.
Detta är något viktigt att ta med sig. När vi reder ut vilken information som hör till en kund, en order eller en artikel lär vi oss samtidigt något om själva verksamhetens domän, vilka företeelser verksamheten behöver hanterar och hur de hänger samman. Inte minst skapar viett gemensamt språk för att hantera allt detta.